Slovní úlohy
Úlohy na poměry a části
Slovní úloha na zlomky a čas: Jak spočítat část z celku
1 Zadání příkladu
Zadání příkladu:
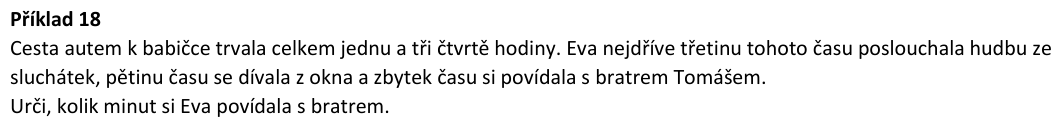
Příklad 18 Cesta autem k babičce trvala celkem jednu a tři čtvrtě hodiny. Eva nejdříve třetinu tohoto času poslouchala hudbu ze sluchátek, pětinu času se dívala z okna a zbytek času si povídala s bratrem Tomášem. Urči, kolik minut si Eva povídala s bratrem.
Zobrazit zadání jako přístupný text
Velikost písma:
Příklad 18
Cesta autem k babičce trvala celkem jednu a tři čtvrtě hodiny. Eva nejdříve třetinu tohoto času poslouchala hudbu ze
sluchátek, pětinu času se dívala z okna a zbytek času si povídala s bratrem Tomášem.
Urči, kolik minut si Eva povídala s bratrem.
Cesta autem k babičce trvala celkem jednu a tři čtvrtě hodiny. Eva nejdříve třetinu tohoto času poslouchala hudbu ze
sluchátek, pětinu času se dívala z okna a zbytek času si povídala s bratrem Tomášem.
Urči, kolik minut si Eva povídala s bratrem.
2 Video řešení s lektorem
Načítám video přehrávač...
3
Správný výsledek
Zobrazit výsledek ▾
Skrýt výsledek ▴
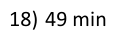
4 Jak ti to šlo?
Ohodnoť, jak ti šel tento příklad. Uloží se ti do tvojí osobní historie pro opakování:
✅ Uloženo!
📊 Spočítáno: 0 / 248
Hodnocení můžeš kdykoliv změnit opětovným kliknutím.
5 Vysvětlení a postup výpočtu
Při řešení slovních úloh s časem a zlomky je prvním klíčovým krokem převod všech časových údajů na stejné jednotky, v tomto případě na minuty. Jedna a tři čtvrtě hodiny představuje 105 minut (60 minut + 45 minut). Pracovat s celými čísly je pro žáky pátých tříd mnohem snazší a přehlednější než počítat se smíšenými čísly nebo zlomky hodin.
Jakmile známe celkovou dobu trvání cesty v minutách, snadno určíme jednotlivé úseky. Třetina z 105 minut určená pro poslech hudby se spočítá jako 105 děleno 3, což je 35 minut. Pětinu z 105 minut věnovanou dívání z okna získáme vydělením číslem 5, tedy 21 minut. Součet těchto dvou činností dává dohromady 56 minut.
Závěrečný krok spočívá v odečtení spotřebovaného času od celkového trvání cesty. Po odečtení 56 minut od 105 minut získáme konečný výsledek: Eva si s bratrem Tomášem povídala celkem 49 minut. Tento postup učí děti systematickému rozkladu složitější úlohy z přijímacích zkoušek na jednoduché dílčí kroky.
Jakmile známe celkovou dobu trvání cesty v minutách, snadno určíme jednotlivé úseky. Třetina z 105 minut určená pro poslech hudby se spočítá jako 105 děleno 3, což je 35 minut. Pětinu z 105 minut věnovanou dívání z okna získáme vydělením číslem 5, tedy 21 minut. Součet těchto dvou činností dává dohromady 56 minut.
Závěrečný krok spočívá v odečtení spotřebovaného času od celkového trvání cesty. Po odečtení 56 minut od 105 minut získáme konečný výsledek: Eva si s bratrem Tomášem povídala celkem 49 minut. Tento postup učí děti systematickému rozkladu složitější úlohy z přijímacích zkoušek na jednoduché dílčí kroky.
6
Přepis výkladu lektora
Zobrazit přepis ▾
Skrýt přepis ▴
import requests
import csv
import re
# ==========================================
# KONFIGURACE (Doplň své údaje z Bunny.net)
# ==========================================
LIBRARY_ID = '427257' # Např. 123456
COLLECTION_ID = 'fcf8fb98-d6bd-4a06-bed4-64b7178af411' # Např. 'a1b2c3d4-e5f6-7890-abcd-ef1234567890'
API_KEY = 'key' # POZOR: Jde o API klíč konkrétní Video Library, ne hlavní klíč účtu!
PULL_ZONE_HOSTNAME = 'vz-57633c32-527.b-cdn.net' # Tvoje streamovací doména (bez https:// na začátku)
# Výstupní soubor
OUTPUT_FILE = 'bunny_videos_export.csv'
# ==========================================
def video_sort_key(video):
"""
Tato funkce vytvoří speciální klíč pro seřazení videí.
Nejprve podle předmětu (MAT první, CJ druhý),
poté podle číselné hodnoty lekce (aby L2 bylo před L10).
"""
title = video.get('title', '').upper()
# 1. Krok: Určíme prioritu předmětu
if 'MAT' in title:
subject_priority = 1
elif 'CJ' in title:
subject_priority = 2
else:
subject_priority = 3 # Pokud by tam bylo něco jiného, hodí to na konec
# 2. Krok: Vytáhneme číslo lekce za písmenem "L"
lesson_num = 0
match = re.search(r'L(\d+)', title)
if match:
lesson_num = int(match.group(1)) # Převede text '10' na skutečné číslo 10
# Skript nejprve seřadí podle subject_priority, při shodě podle lesson_num a jako zálohu použije název
return (subject_priority, lesson_num, title)
def export_bunny_videos():
url = f"https://video.bunnycdn.com/library/{LIBRARY_ID}/videos"
headers = {
"AccessKey": API_KEY,
"Accept": "application/json"
}
page = 1
items_per_page = 100
has_more = True
all_videos = []
print(f"Stahuji data pro kolekci: {COLLECTION_ID} z knihovny: {LIBRARY_ID}...")
while has_more:
params = {
"collection": COLLECTION_ID,
"page": page,
"itemsPerPage": items_per_page
}
response = requests.get(url, headers=headers, params=params)
if response.status_code != 200:
print(f"Chyba API: {response.status_code} - {response.text}")
break
data = response.json()
items = data.get('items', [])
if not items:
break
all_videos.extend(items)
total_items = data.get('totalItems', 0)
if len(all_videos) >= total_items:
has_more = False
else:
page += 1
# ZDE PROBĚHNE VLASTNÍ SEŘAZENÍ PODLE NAŠÍ FUNKCE
all_videos.sort(key=video_sort_key)
print(f"Staženo a seřazeno {len(all_videos)} videí. Ukládám do CSV...")
csv_headers = [
'video_title',
'bunny_video_guid',
'bunny_library_id',
'bunny_collection_id',
'bunny_thumbnail_filename',
'bunny_preview_animation_url',
'duration_seconds'
]
with open(OUTPUT_FILE, mode='w', newline='', encoding='utf-8') as file:
writer = csv.DictWriter(file, fieldnames=csv_headers)
writer.writeheader()
for video in all_videos:
guid = video.get('guid')
thumbnail_name = video.get('thumbnailFileName')
thumbnail_url = f"https://{PULL_ZONE_HOSTNAME}/{guid}/{thumbnail_name}" if thumbnail_name else None
preview_url = f"https://{PULL_ZONE_HOSTNAME}/{guid}/preview.webp"
writer.writerow({
'video_title': video.get('title'),
'bunny_video_guid': guid,
'bunny_library_id': video.get('videoLibraryId'),
'bunny_collection_id': video.get('collectionId'),
'bunny_thumbnail_filename': thumbnail_url,
'bunny_preview_animation_url': preview_url,
'duration_seconds': video.get('length')
})
print(f"Hotovo! Export byl uložen do souboru: {OUTPUT_FILE}")
if __name__ == "__main__":
export_bunny_videos()
import csv
import re
# ==========================================
# KONFIGURACE (Doplň své údaje z Bunny.net)
# ==========================================
LIBRARY_ID = '427257' # Např. 123456
COLLECTION_ID = 'fcf8fb98-d6bd-4a06-bed4-64b7178af411' # Např. 'a1b2c3d4-e5f6-7890-abcd-ef1234567890'
API_KEY = 'key' # POZOR: Jde o API klíč konkrétní Video Library, ne hlavní klíč účtu!
PULL_ZONE_HOSTNAME = 'vz-57633c32-527.b-cdn.net' # Tvoje streamovací doména (bez https:// na začátku)
# Výstupní soubor
OUTPUT_FILE = 'bunny_videos_export.csv'
# ==========================================
def video_sort_key(video):
"""
Tato funkce vytvoří speciální klíč pro seřazení videí.
Nejprve podle předmětu (MAT první, CJ druhý),
poté podle číselné hodnoty lekce (aby L2 bylo před L10).
"""
title = video.get('title', '').upper()
# 1. Krok: Určíme prioritu předmětu
if 'MAT' in title:
subject_priority = 1
elif 'CJ' in title:
subject_priority = 2
else:
subject_priority = 3 # Pokud by tam bylo něco jiného, hodí to na konec
# 2. Krok: Vytáhneme číslo lekce za písmenem "L"
lesson_num = 0
match = re.search(r'L(\d+)', title)
if match:
lesson_num = int(match.group(1)) # Převede text '10' na skutečné číslo 10
# Skript nejprve seřadí podle subject_priority, při shodě podle lesson_num a jako zálohu použije název
return (subject_priority, lesson_num, title)
def export_bunny_videos():
url = f"https://video.bunnycdn.com/library/{LIBRARY_ID}/videos"
headers = {
"AccessKey": API_KEY,
"Accept": "application/json"
}
page = 1
items_per_page = 100
has_more = True
all_videos = []
print(f"Stahuji data pro kolekci: {COLLECTION_ID} z knihovny: {LIBRARY_ID}...")
while has_more:
params = {
"collection": COLLECTION_ID,
"page": page,
"itemsPerPage": items_per_page
}
response = requests.get(url, headers=headers, params=params)
if response.status_code != 200:
print(f"Chyba API: {response.status_code} - {response.text}")
break
data = response.json()
items = data.get('items', [])
if not items:
break
all_videos.extend(items)
total_items = data.get('totalItems', 0)
if len(all_videos) >= total_items:
has_more = False
else:
page += 1
# ZDE PROBĚHNE VLASTNÍ SEŘAZENÍ PODLE NAŠÍ FUNKCE
all_videos.sort(key=video_sort_key)
print(f"Staženo a seřazeno {len(all_videos)} videí. Ukládám do CSV...")
csv_headers = [
'video_title',
'bunny_video_guid',
'bunny_library_id',
'bunny_collection_id',
'bunny_thumbnail_filename',
'bunny_preview_animation_url',
'duration_seconds'
]
with open(OUTPUT_FILE, mode='w', newline='', encoding='utf-8') as file:
writer = csv.DictWriter(file, fieldnames=csv_headers)
writer.writeheader()
for video in all_videos:
guid = video.get('guid')
thumbnail_name = video.get('thumbnailFileName')
thumbnail_url = f"https://{PULL_ZONE_HOSTNAME}/{guid}/{thumbnail_name}" if thumbnail_name else None
preview_url = f"https://{PULL_ZONE_HOSTNAME}/{guid}/preview.webp"
writer.writerow({
'video_title': video.get('title'),
'bunny_video_guid': guid,
'bunny_library_id': video.get('videoLibraryId'),
'bunny_collection_id': video.get('collectionId'),
'bunny_thumbnail_filename': thumbnail_url,
'bunny_preview_animation_url': preview_url,
'duration_seconds': video.get('length')
})
print(f"Hotovo! Export byl uložen do souboru: {OUTPUT_FILE}")
if __name__ == "__main__":
export_bunny_videos()